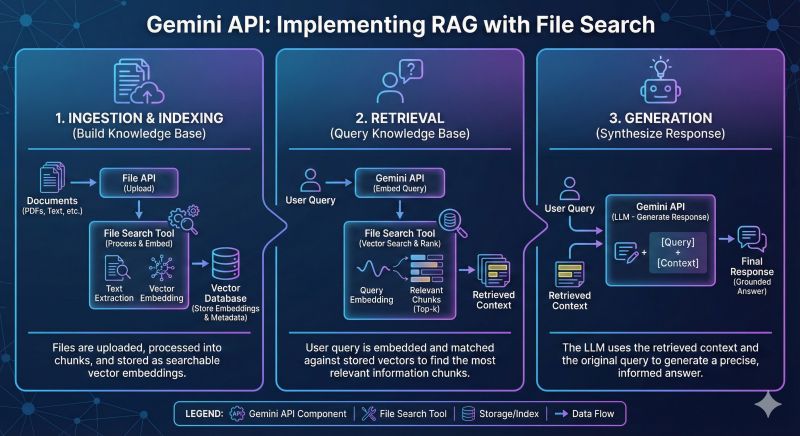
寫 RAG 唔使再煩 Vector DB?試下 Gemini API 嘅 File Processing
最近用咗 Gemini API 嘅 File Search / Document Processing 功能,發現真係慳力好多。
以往我們要寫 RAG,通常都要經歷: ❌ Parse PDF/Docs ❌ 做 Chunking (切分文字) ❌ 生成 Embeddings 再存入 Vector Database ❌ 寫 Logic 做 Semantic Search
而家利用 Gemini API 嘅 File capability 配合佢超大嘅 Context Window (Flash 都有 1M tokens),成個流程簡化咗好多。
幾點觀察:\
- 開發速度極快:幾行 Code 搞掂,不用維護額外的 Database。\
- 理解力強:因為模型讀晒全文 (Full context),比起傳統 RAG 只抽幾段文字 (Chunks) 出嚟,佢更少出現斷章取義嘅情況。\
- Cost-effective:對於中小型項目,比起養一個 Vector DB 更划算。
如果你仲苦惱緊點樣快速砌個 Demo 俾客睇,強烈建議試下呢條路!🚀
💻 Code Example:
# 1. Upload File
doc = genai.upload_file(“spec.pdf”)
# 2. Init Model (Flash 1.5)
model = genai.GenerativeModel(“gemini-1.5-flash”)
# 3. Ask with Context (Native RAG)
response = model.generate_content([doc, “Summarize the key points.”])
print(response.text)